最初は、計算式を作ればよいと思っていた
HLRの基本的な考え方は、建設・運転管理・維持修繕・更新・間接労働・廃止撤去といった各段階に必要な人的労働量を積み上げることです。最初はシンプルに考えていました。それぞれの労働量を計算する式を作り、合計すればHLRを算出できる、と。
実際、橋梁や建物、発電設備などのモデルケースでは、手計算によってHLRを試算することができました。計算式そのものは、面倒でしたがそう難しくはありませんでした。
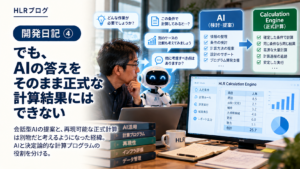
しかし、Calculation Engineとして実装しようとした段階で、計算式だけでは解決できない問題が次々に出てきました。
計算式に入れる数字は、どこから来るのか?
橋梁の点検に必要な人的労働量を例にとります。仮に1回の点検を4人で2日間実施するなら、必要な労働量は8人日です。計算そのものは簡単です。
しかし実際には、こんな疑問が浮かびます。4人という人数は何を根拠に設定したのか。2日間という作業日数は実績なのか、仮定なのか。その数字は別の規模の橋梁にも使えるのか。将来、点検技術が変わったらどう扱うのか。
計算式が正しくても、そこに入れる数字の根拠が不明確では、結果を評価することができません。「どうしてこの数字を使ったのか」という問いに答えられなければ、計算結果の信頼性を説明できないのです。
こうして、入力条件だけでなく、使用する係数や根拠データも整理・管理する必要があると分かってきました。
計算できても、後から同じ結果を出せるとは限らない
再現性の問題は、さらに一段深いところにありました。
例えば、今年ある橋梁のHLRを計算して30人年という結果が出たとします。翌年、同じ橋梁を同じ入力条件で計算したところ、32人年になった。なぜでしょうか。
点検作業の係数が改訂されていたのかもしれません。計算ルールの一部を修正していたのかもしれません。あるいは入力条件のどこかが変わっていたのかもしれません。どれが原因なのかを追えなければ、計算結果を検証することができません。
再現性とは、「今日同じ答えが出ること」だけではない——そう気づきました。「過去の計算を後から確認できること」も、再現性の重要な意味のひとつです。そのためには、入力条件だけでなく、使用した係数、計算ルール、それぞれのバージョン、計算の履歴を結びつけて残す必要があります。
そこで、システム全体の構造を考え始めた
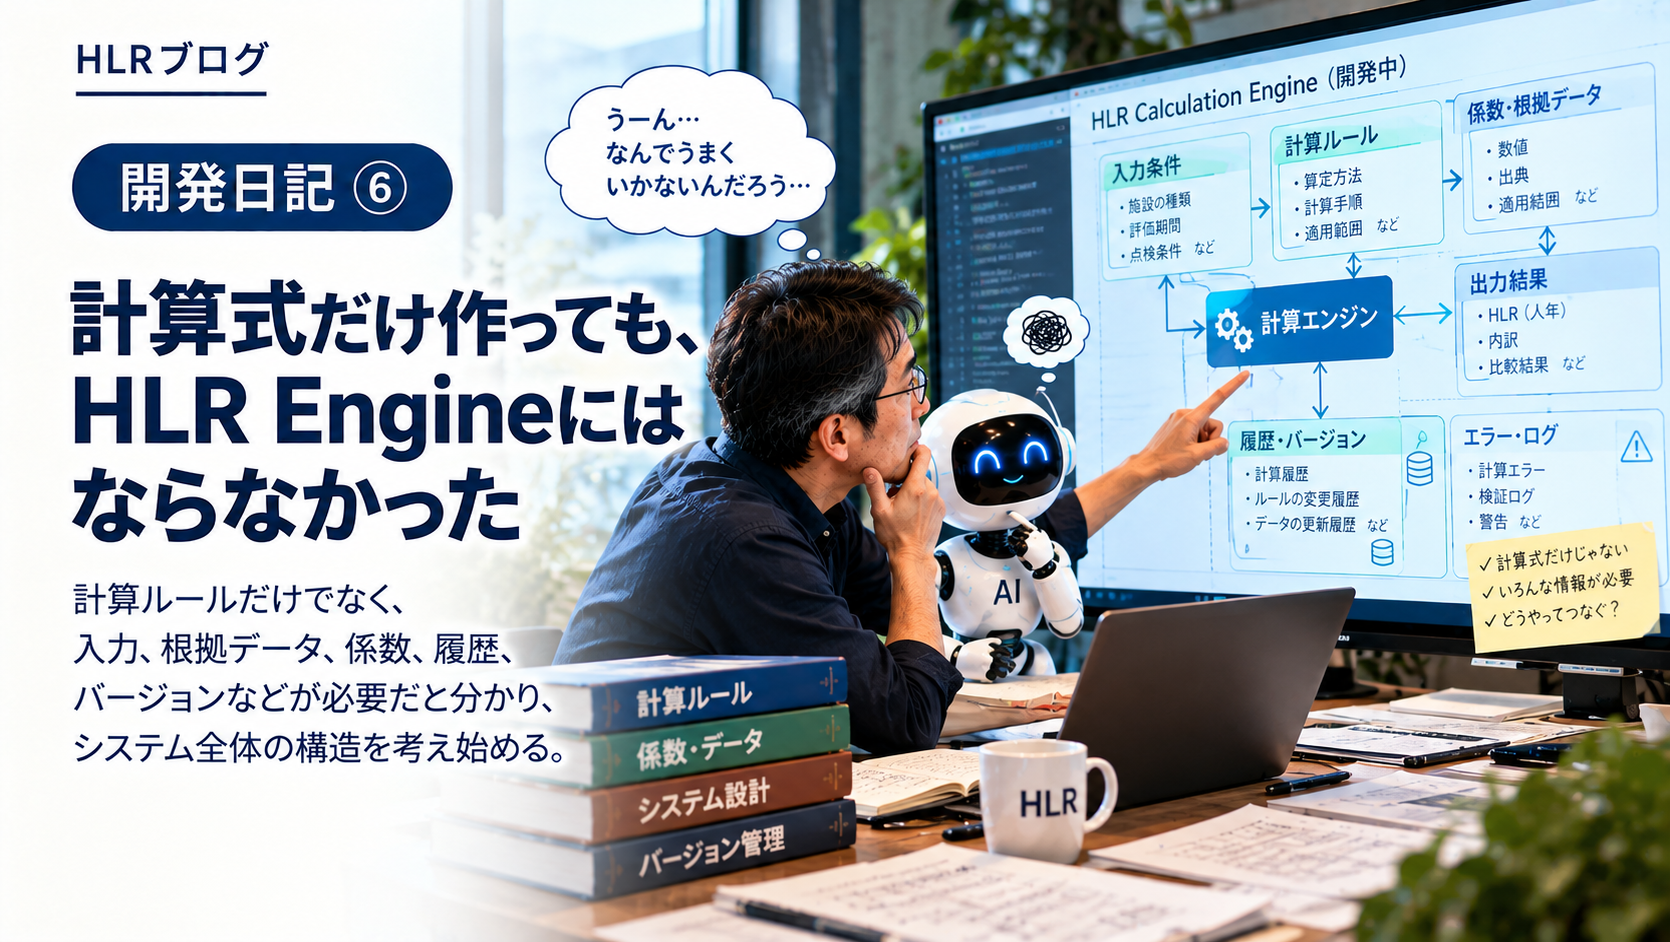
ここからが今回の開発で最も重要な転換点でした。入力条件、係数、計算ルール、計算結果、履歴——これまで個別に考えていたものを、どうつなぐか。
考えてみると、HLR Calculation Engineに必要なのは次のような構造です。
まず、施設の条件・評価期間・計算対象を記録するInput Cardがあります。次に、使用する数値・出典・適用範囲を管理する係数・根拠データがあります。そして、算定方法と計算手順を定める計算ルールがあります。これらを受け取り、決められた条件とルールに従って計算を実行するのがHLR Calculation Engine本体です。最後に、計算結果・使用した条件・係数・ルールのバージョンを結びつけた計算履歴が残ります。
こうした構造によって、計算結果がどの条件・係数・ルールに基づいているかを追跡できるようになります。将来、新しい係数や計算ルールを追加・修正する場面でも、既存の計算結果との関係を管理しやすくなります。
計算式を増やす前に、土台を作る
HLRでは、橋梁・水道・下水道・建物・発電設備など、さまざまなインフラを扱うことを想定しています。分野が違えば、使用する係数も計算の方法も当然異なります。
もし計算式ごとに入力データや係数を個別に管理していたら、対象分野が増えるたびにシステムは複雑になる一方です。メンテナンスも難しくなります。
だからこそ、計算式を次々に増やす前に、入力・係数・計算ルール・結果・履歴を共通の仕組みで管理できる土台を先に作る必要がありました。機能の追加より、拡張できる構造づくりを優先する——これが今回の開発判断の中心です。
HLRの計算式を作ることと、HLR Calculation Engineを作ることは、同じではありませんでした。計算式は、答えを出すためのものです。一方Calculation Engineには、その答えがどこから来たのかを確認でき、後から検証し、必要に応じて計算し直せる仕組みが必要です。こうして、計算式だけでなく、システム全体の構造を考える開発へと進んでいきました。


コメント